TRAININGSDATEN FÜR PHYSICAL AI

Wie Roboter aus realer Industriearbeit lernen

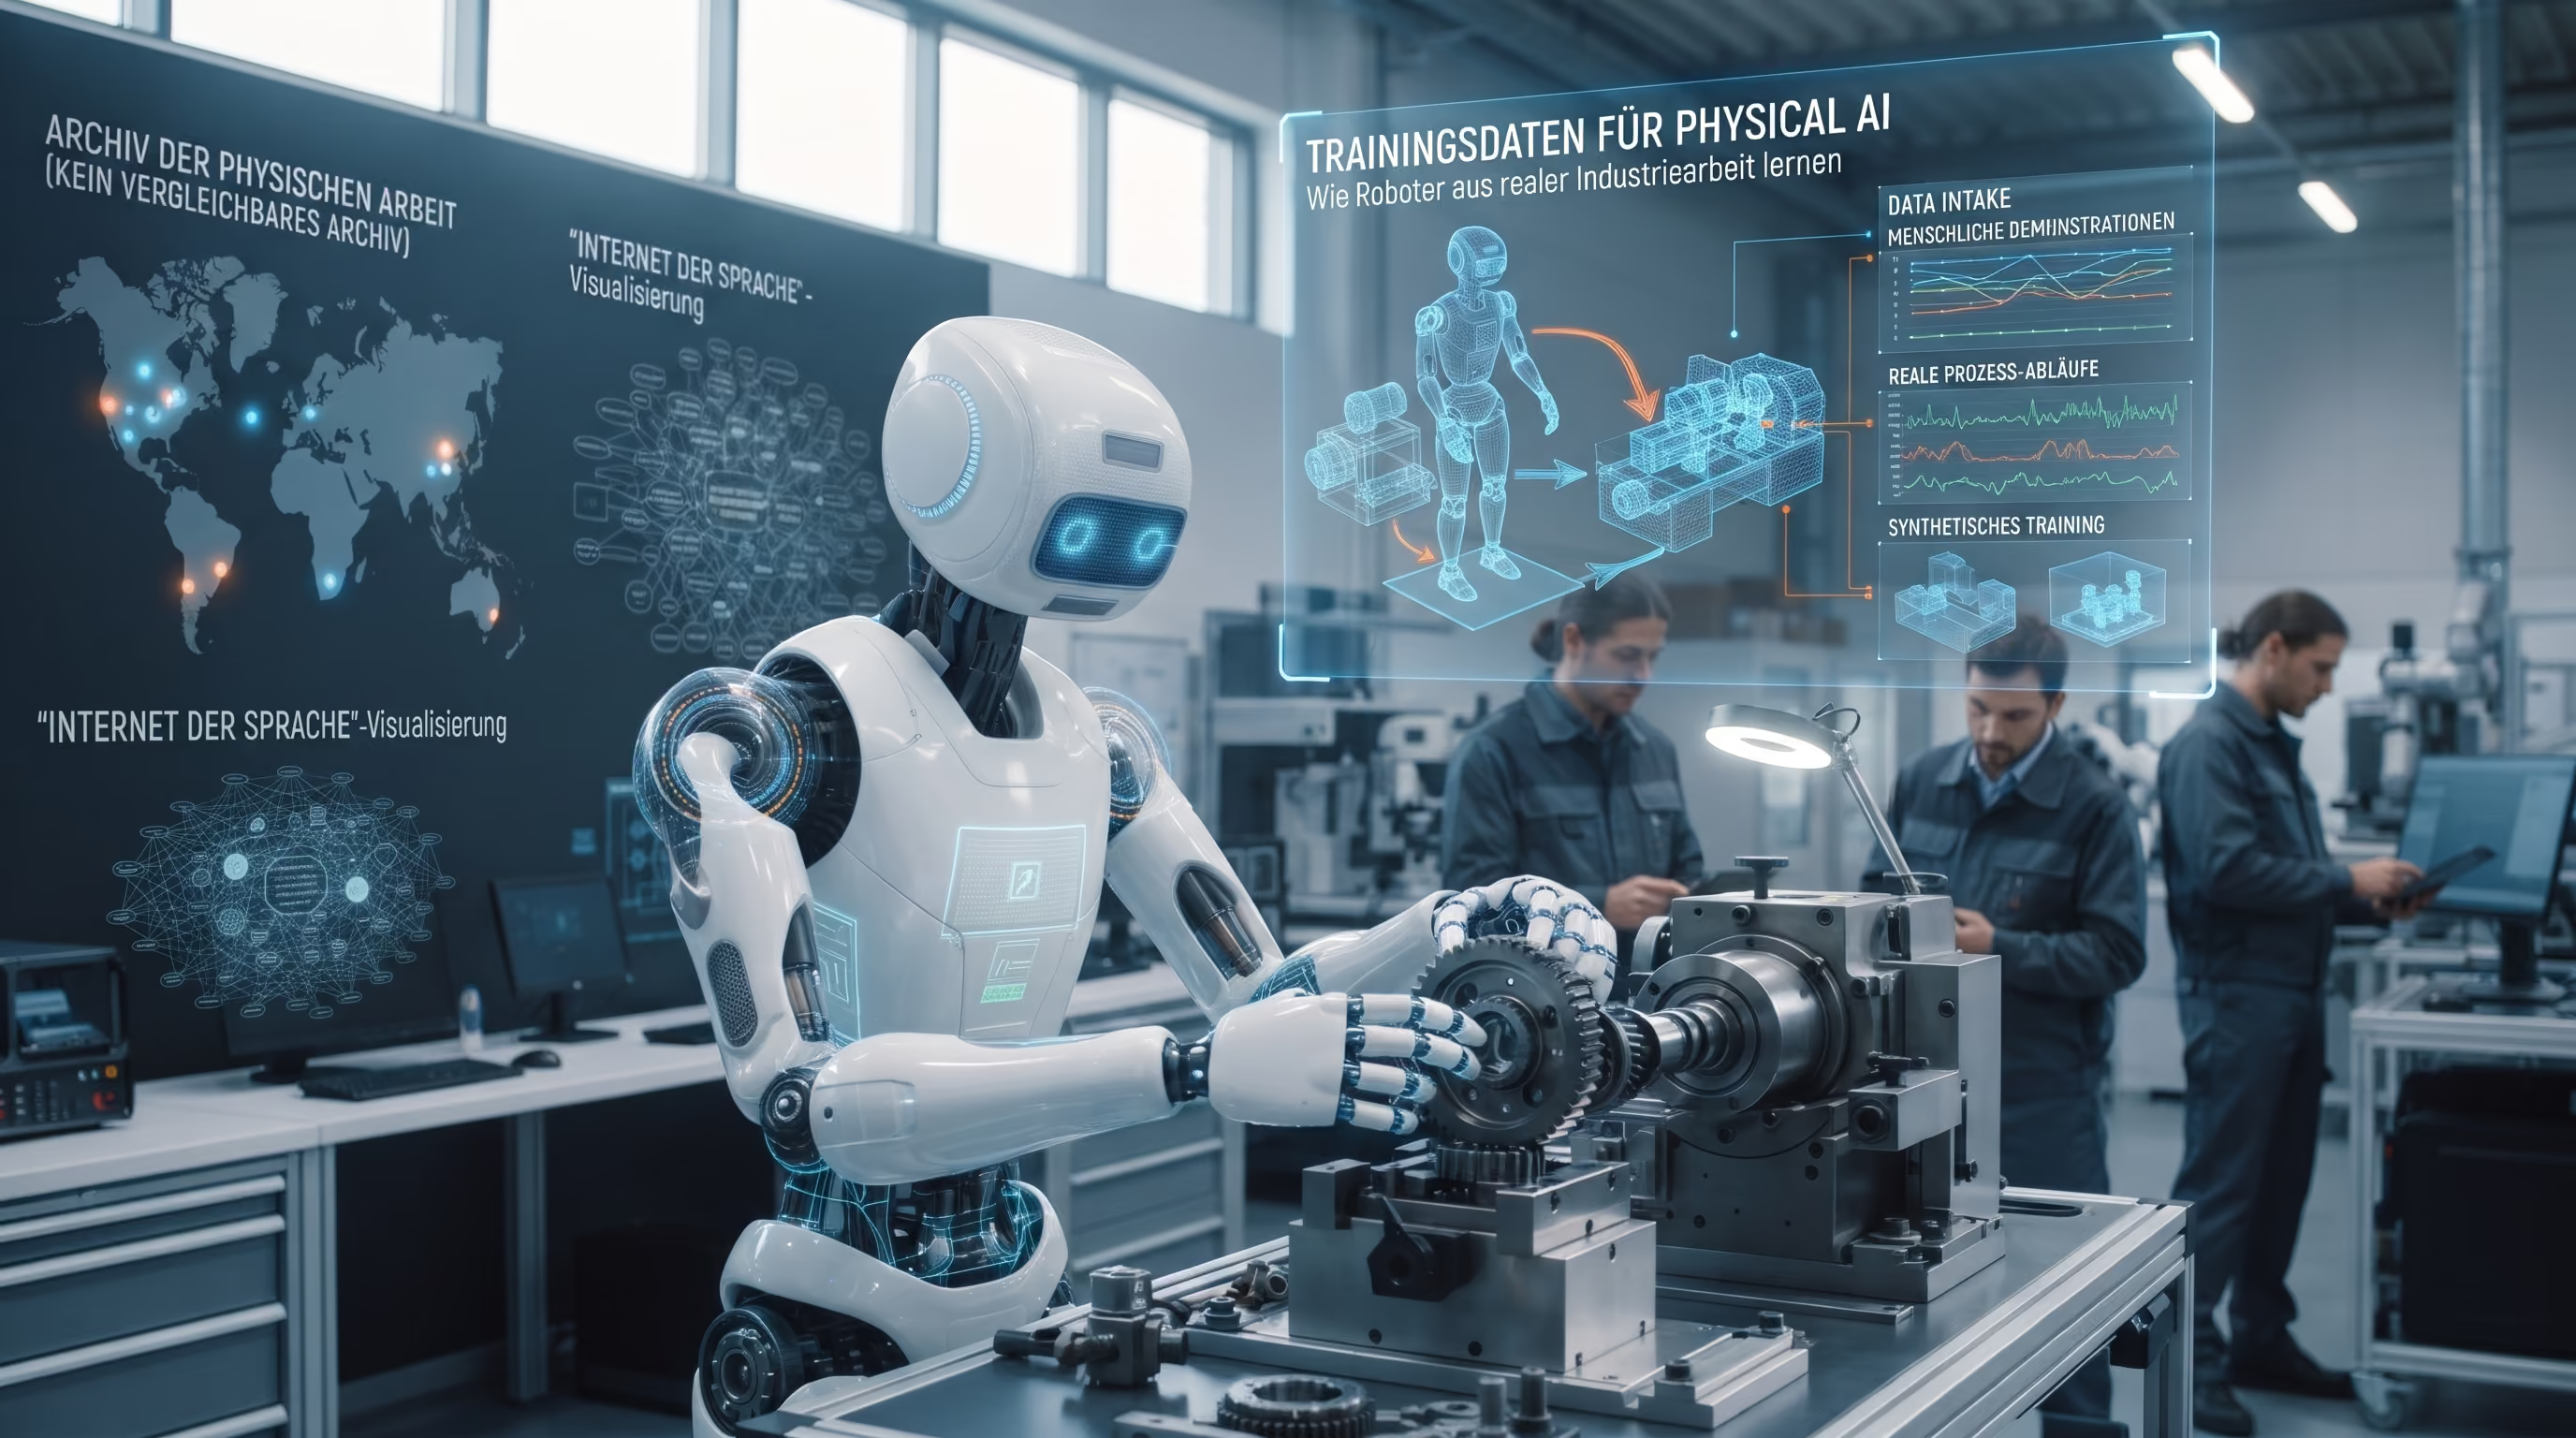
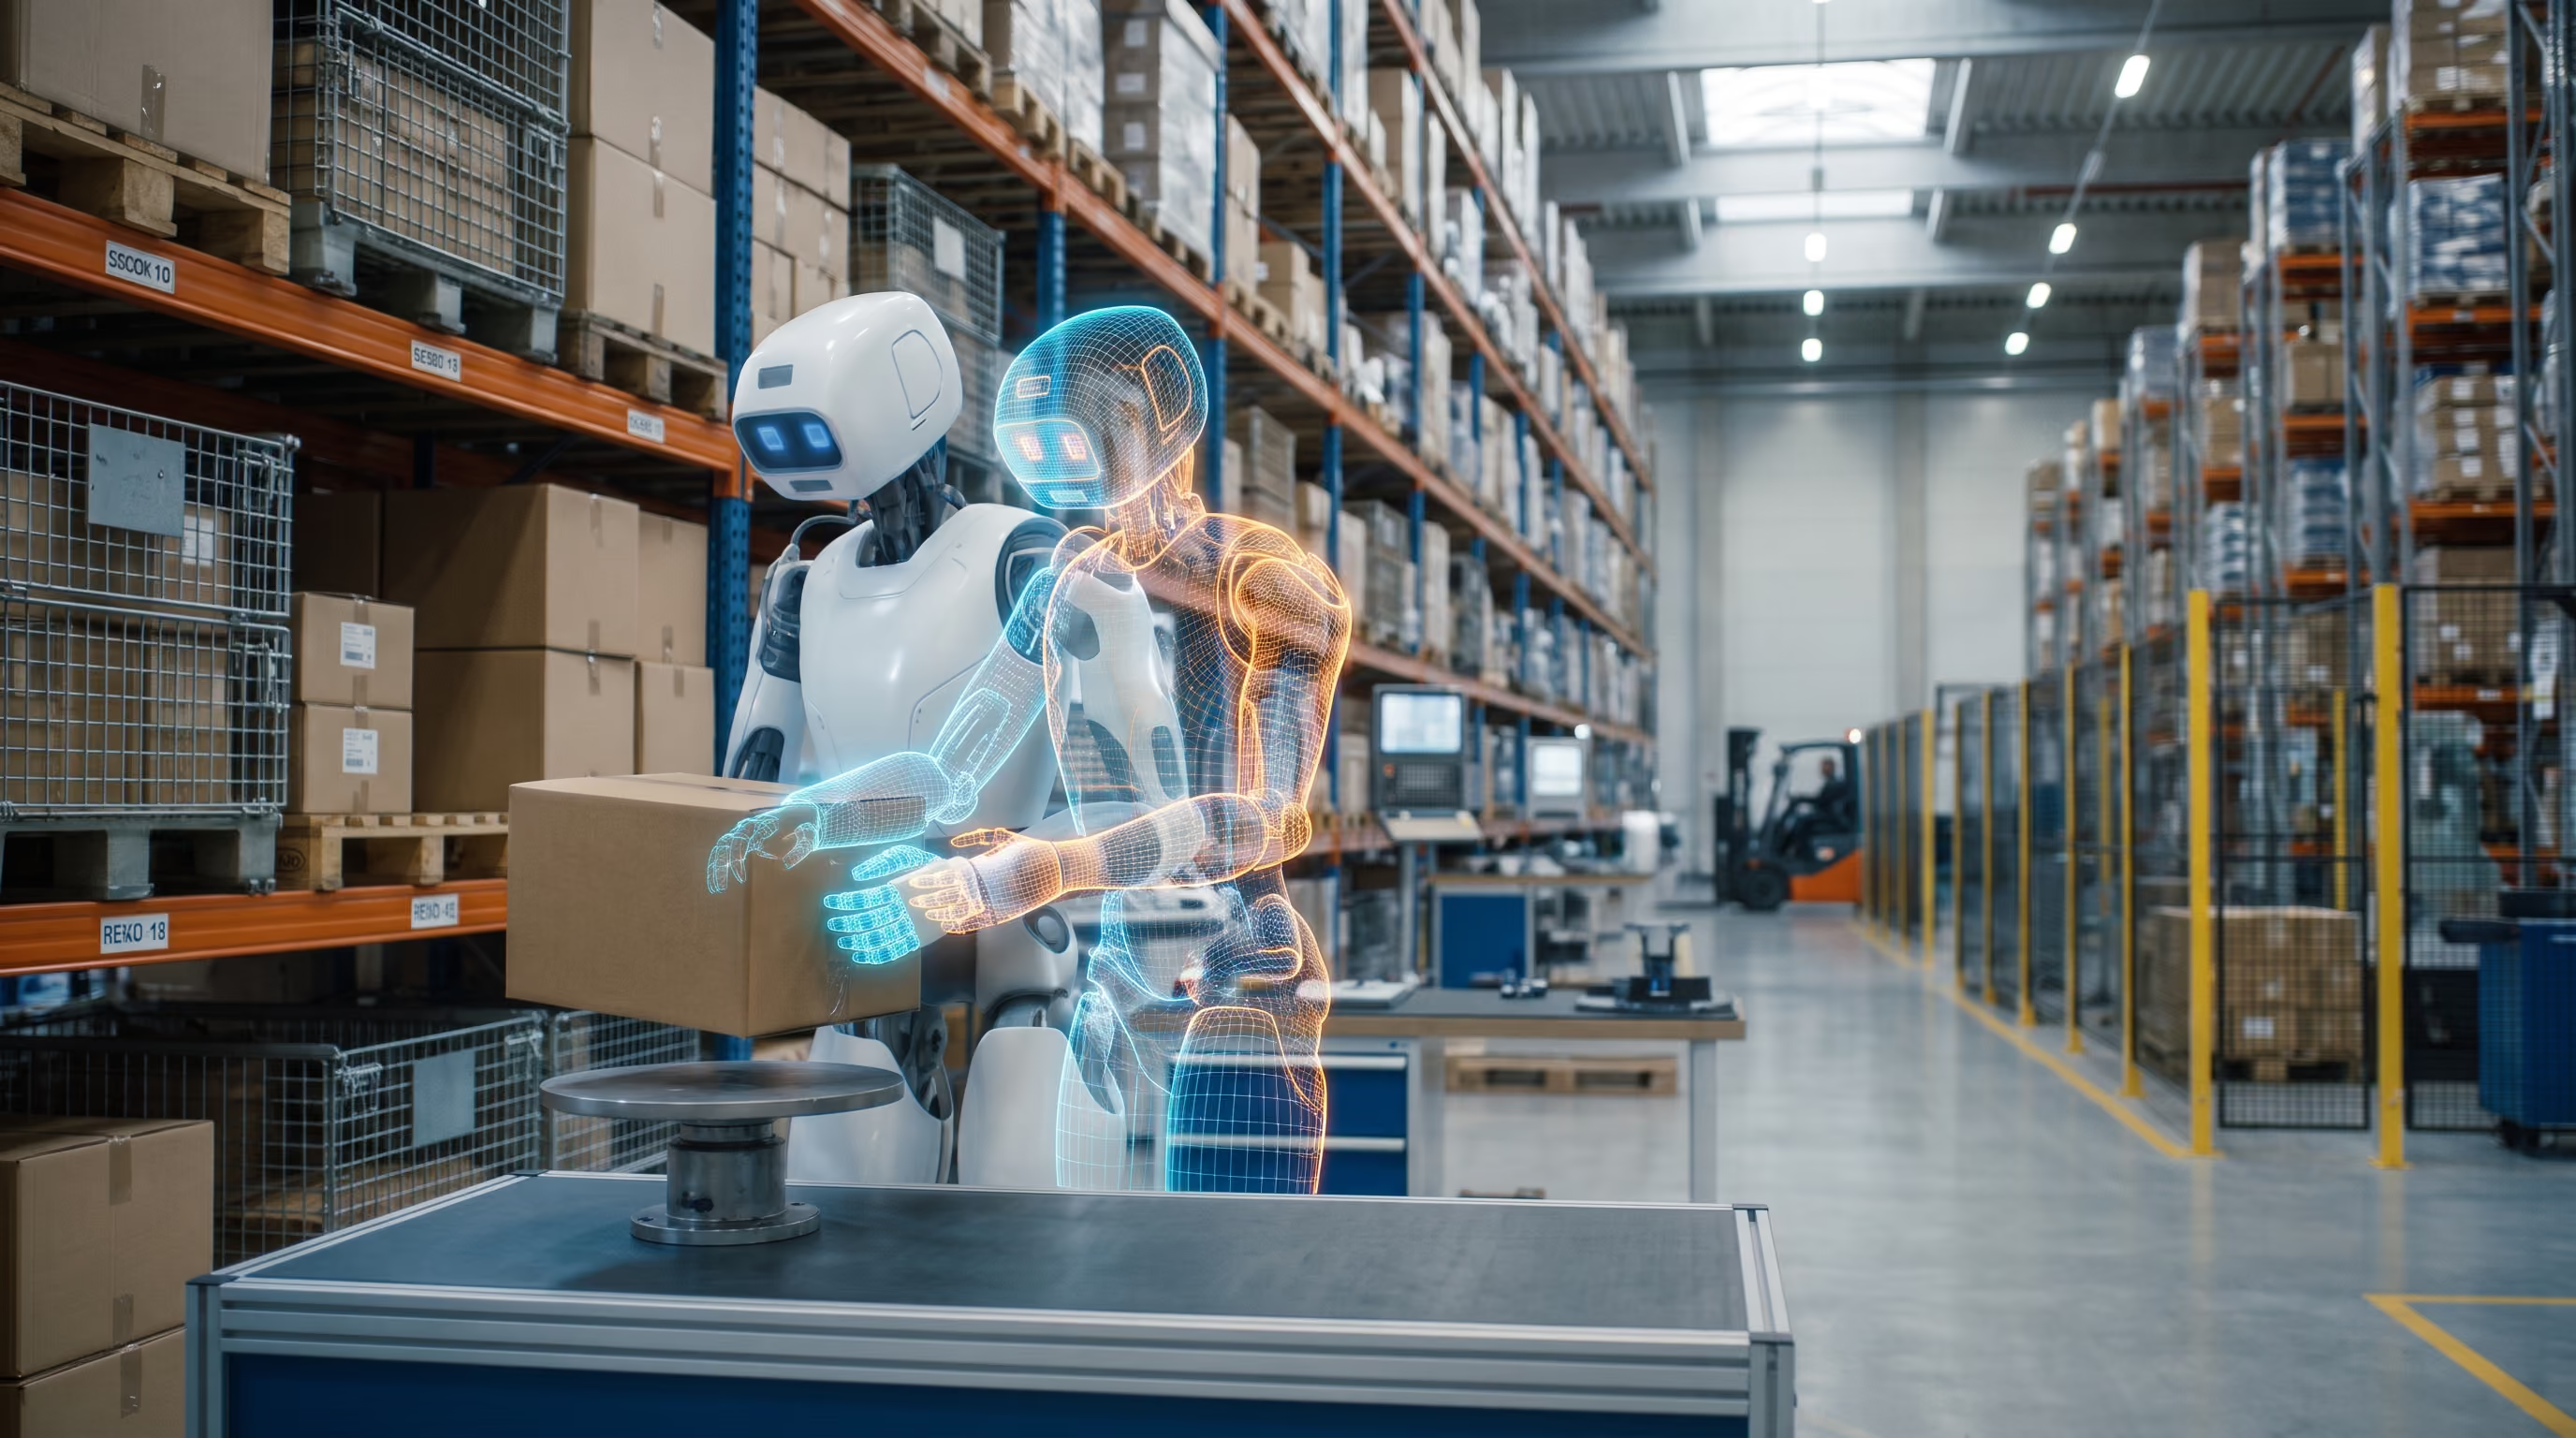
Trainingsdaten für Physical AI sind aufgezeichnete Bewegungen, Handlungen und Prozessabläufe, aus denen Robotik-Modelle lernen, physische Aufgaben auszuführen. Sie gelten als größter Engpass der Branche: Für Sprache gibt es das Internet, für physische Arbeit gibt es kein vergleichbares Archiv.

5 min Lesezeit
DER LIMITIERENDE FAKTOR

Warum sind Daten der Engpass bei Physical AI?

Sprachmodelle lernen aus Milliarden frei verfügbarer Texte. Jede Bewegung, aus der ein Roboter lernen soll, muss dagegen erst erfasst werden. Besonders knapp sind Daten darüber, wie Arbeit in realen Lagern und Fabriken aussieht: welche Handgriffe wie oft vorkommen, wie lange sie dauern, wo Menschen ausweichen, warten oder schwer heben. Robotik-Foundation-Models entwickeln sich rasant, sind aber nur so gut wie die Daten, mit denen sie trainiert werden. Wer besser versteht, wie physische Arbeit tatsächlich abläuft, trainiert bessere Modelle.

HERKUNFT DER DATEN

Welche Datenquellen gibt es?

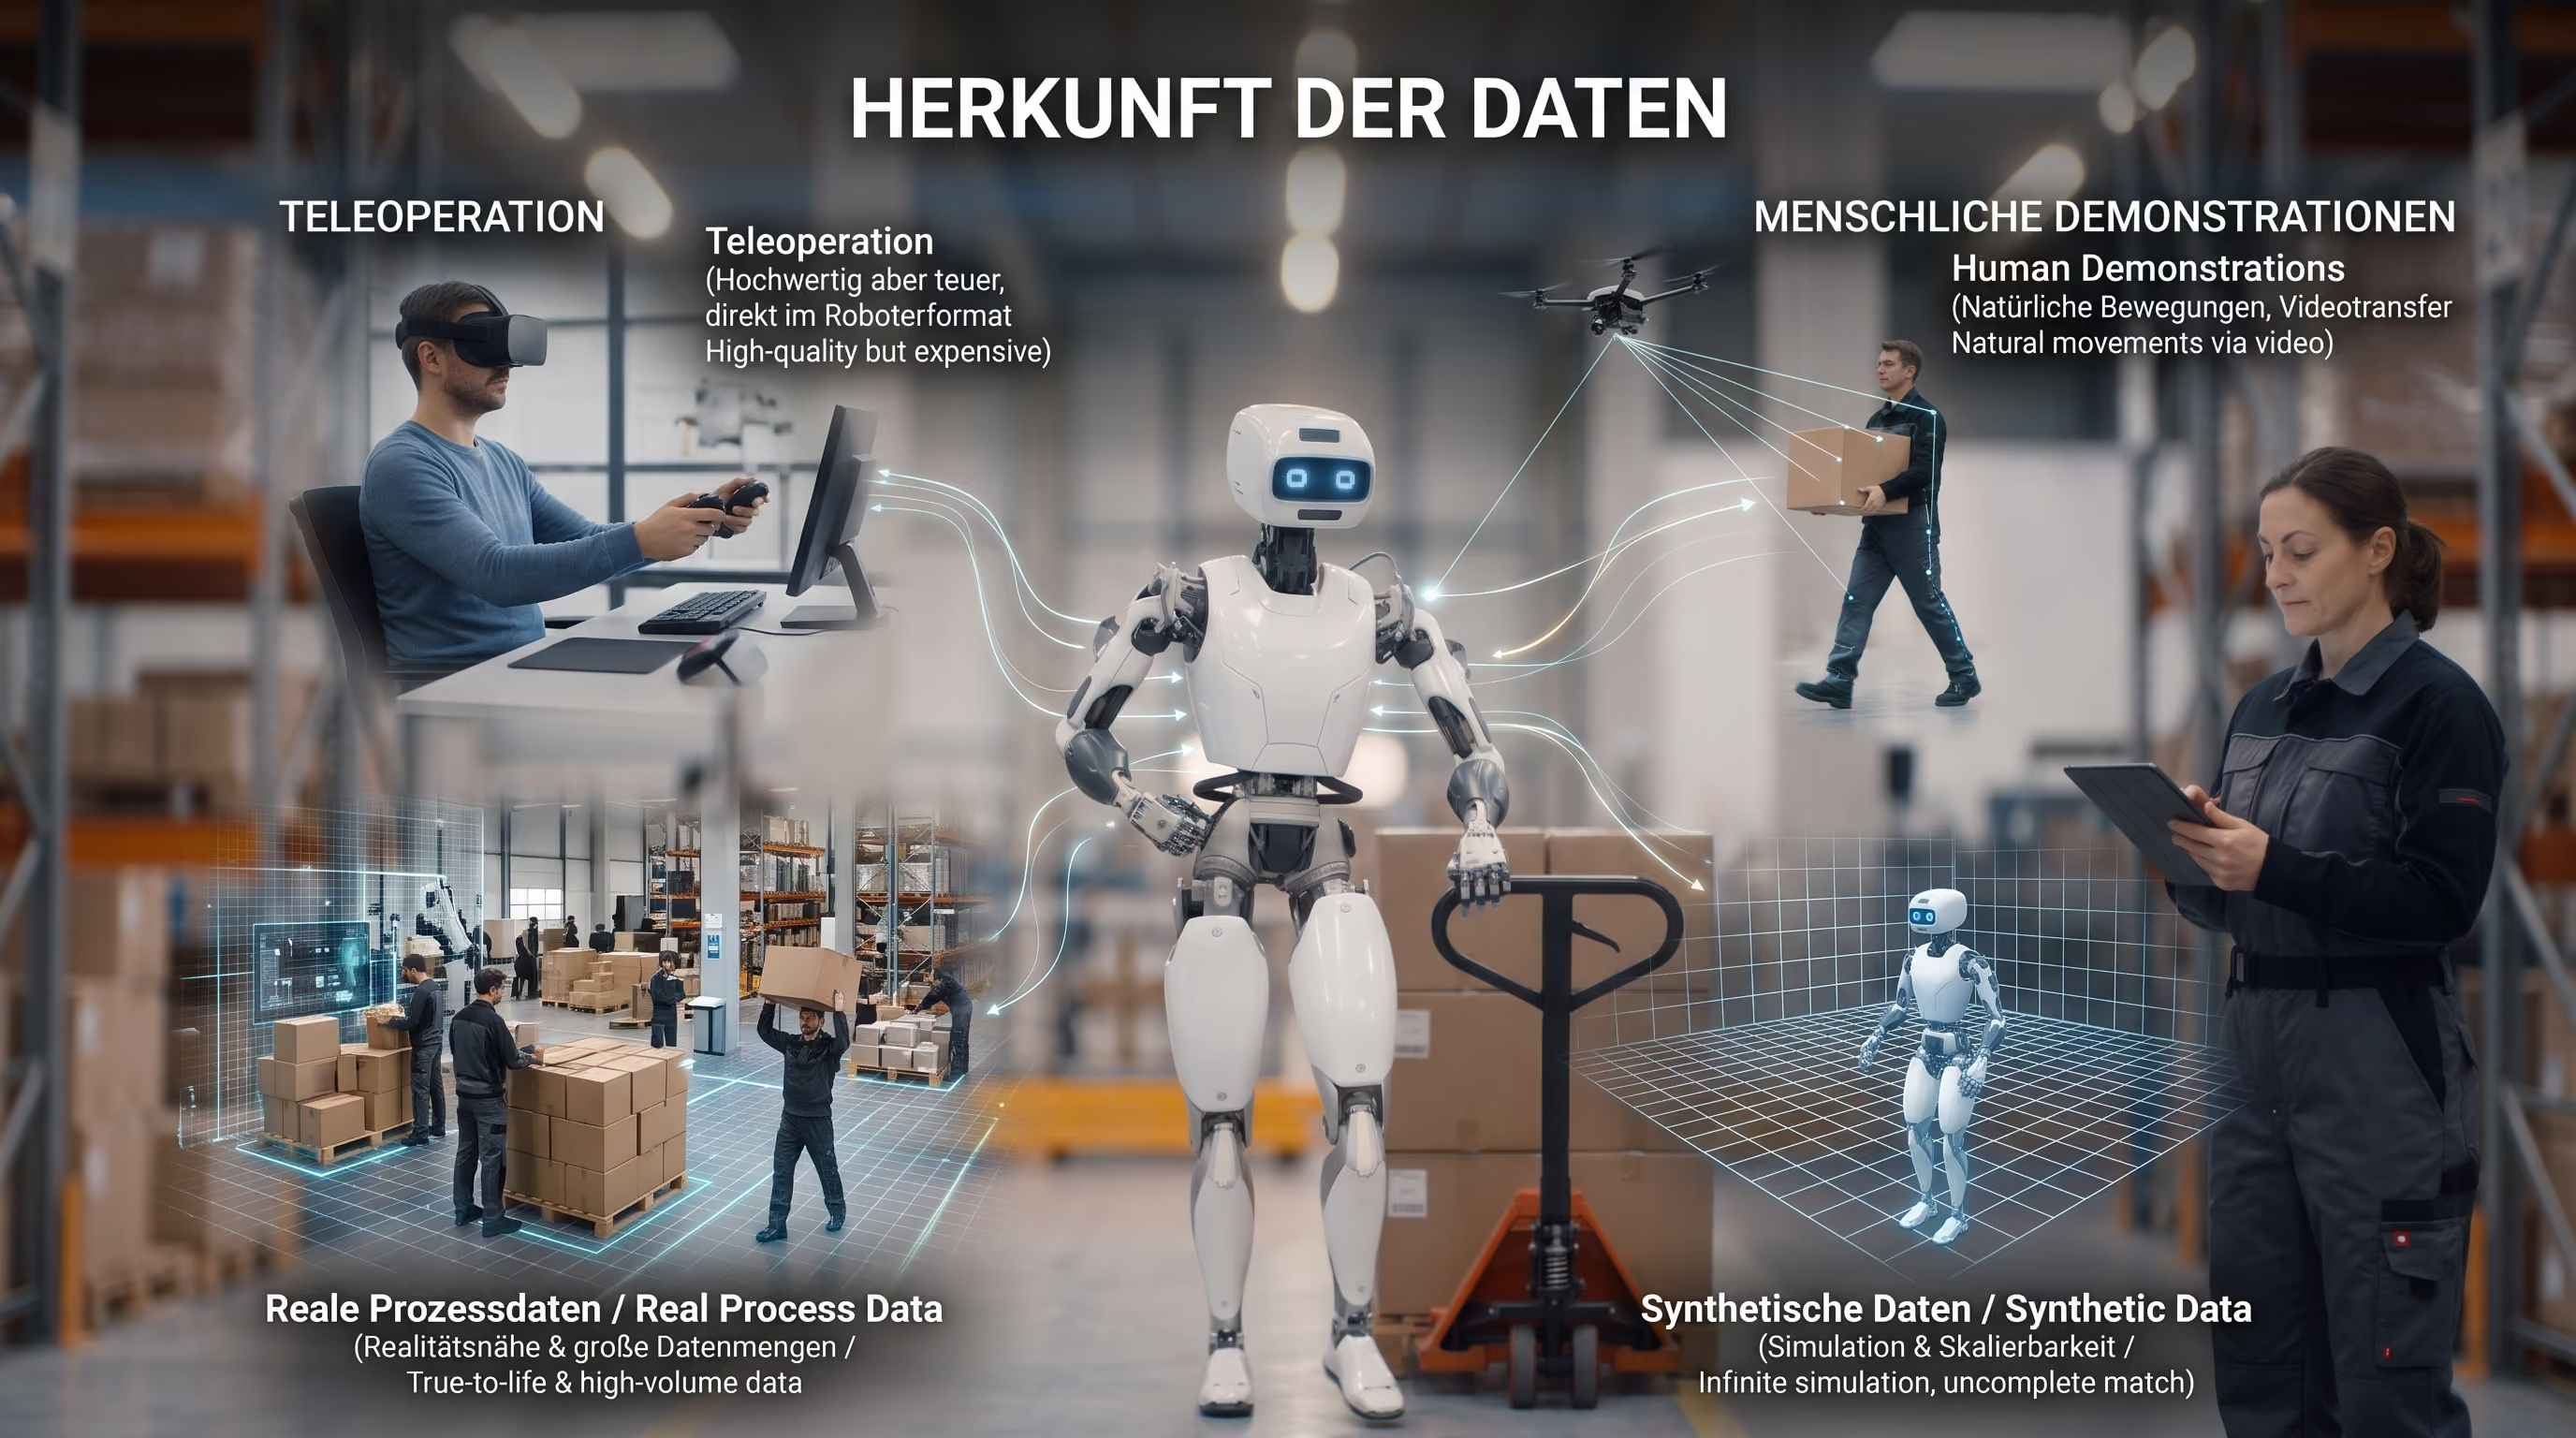
Robotik-Modelle lernen heute aus vier Arten von Daten, die sich in Qualität, Kosten und Realitätsnähe deutlich unterscheiden. Bei der Teleoperation steuert ein Mensch den Roboter fern, und das System lernt aus den aufgezeichneten Bewegungen. Diese Daten sind hochwertig und liegen direkt im Format des Roboters vor, sind aber teuer, langsam zu erzeugen und an ein bestimmtes Robotermodell gebunden. Menschliche Demonstrationen sind Videos und Bewegungsdaten von Menschen, die eine Aufgabe ausführen. Sie bilden natürliche Bewegungen ab und lassen sich gut auf humanoide Roboter übertragen, müssen aber erst auf den Roboterkörper umgerechnet werden. Reale Prozessdaten zeigen, wie oft, wie lange und unter welchen Bedingungen Tätigkeiten im laufenden Betrieb stattfinden. Ihre Stärke ist die Realitätsnähe mit echter Variabilität und großen Datenmengen; dafür braucht es Zugang zu laufenden Betrieben. Synthetische Daten schließlich entstehen in Simulationen oder Weltmodellen. Sie lassen sich beliebig vervielfältigen und gefahrlos erzeugen, bilden die Realität ohne Abgleich mit echten Daten aber nur unvollständig ab. In der Praxis werden die Quellen kombiniert: Synthetische Daten vervielfältigen reale Daten, ersetzen sie aber nicht.
TRAININGSDATEN AUS DER INDUSTRIE

Was bedeutet Industrial Training Data?

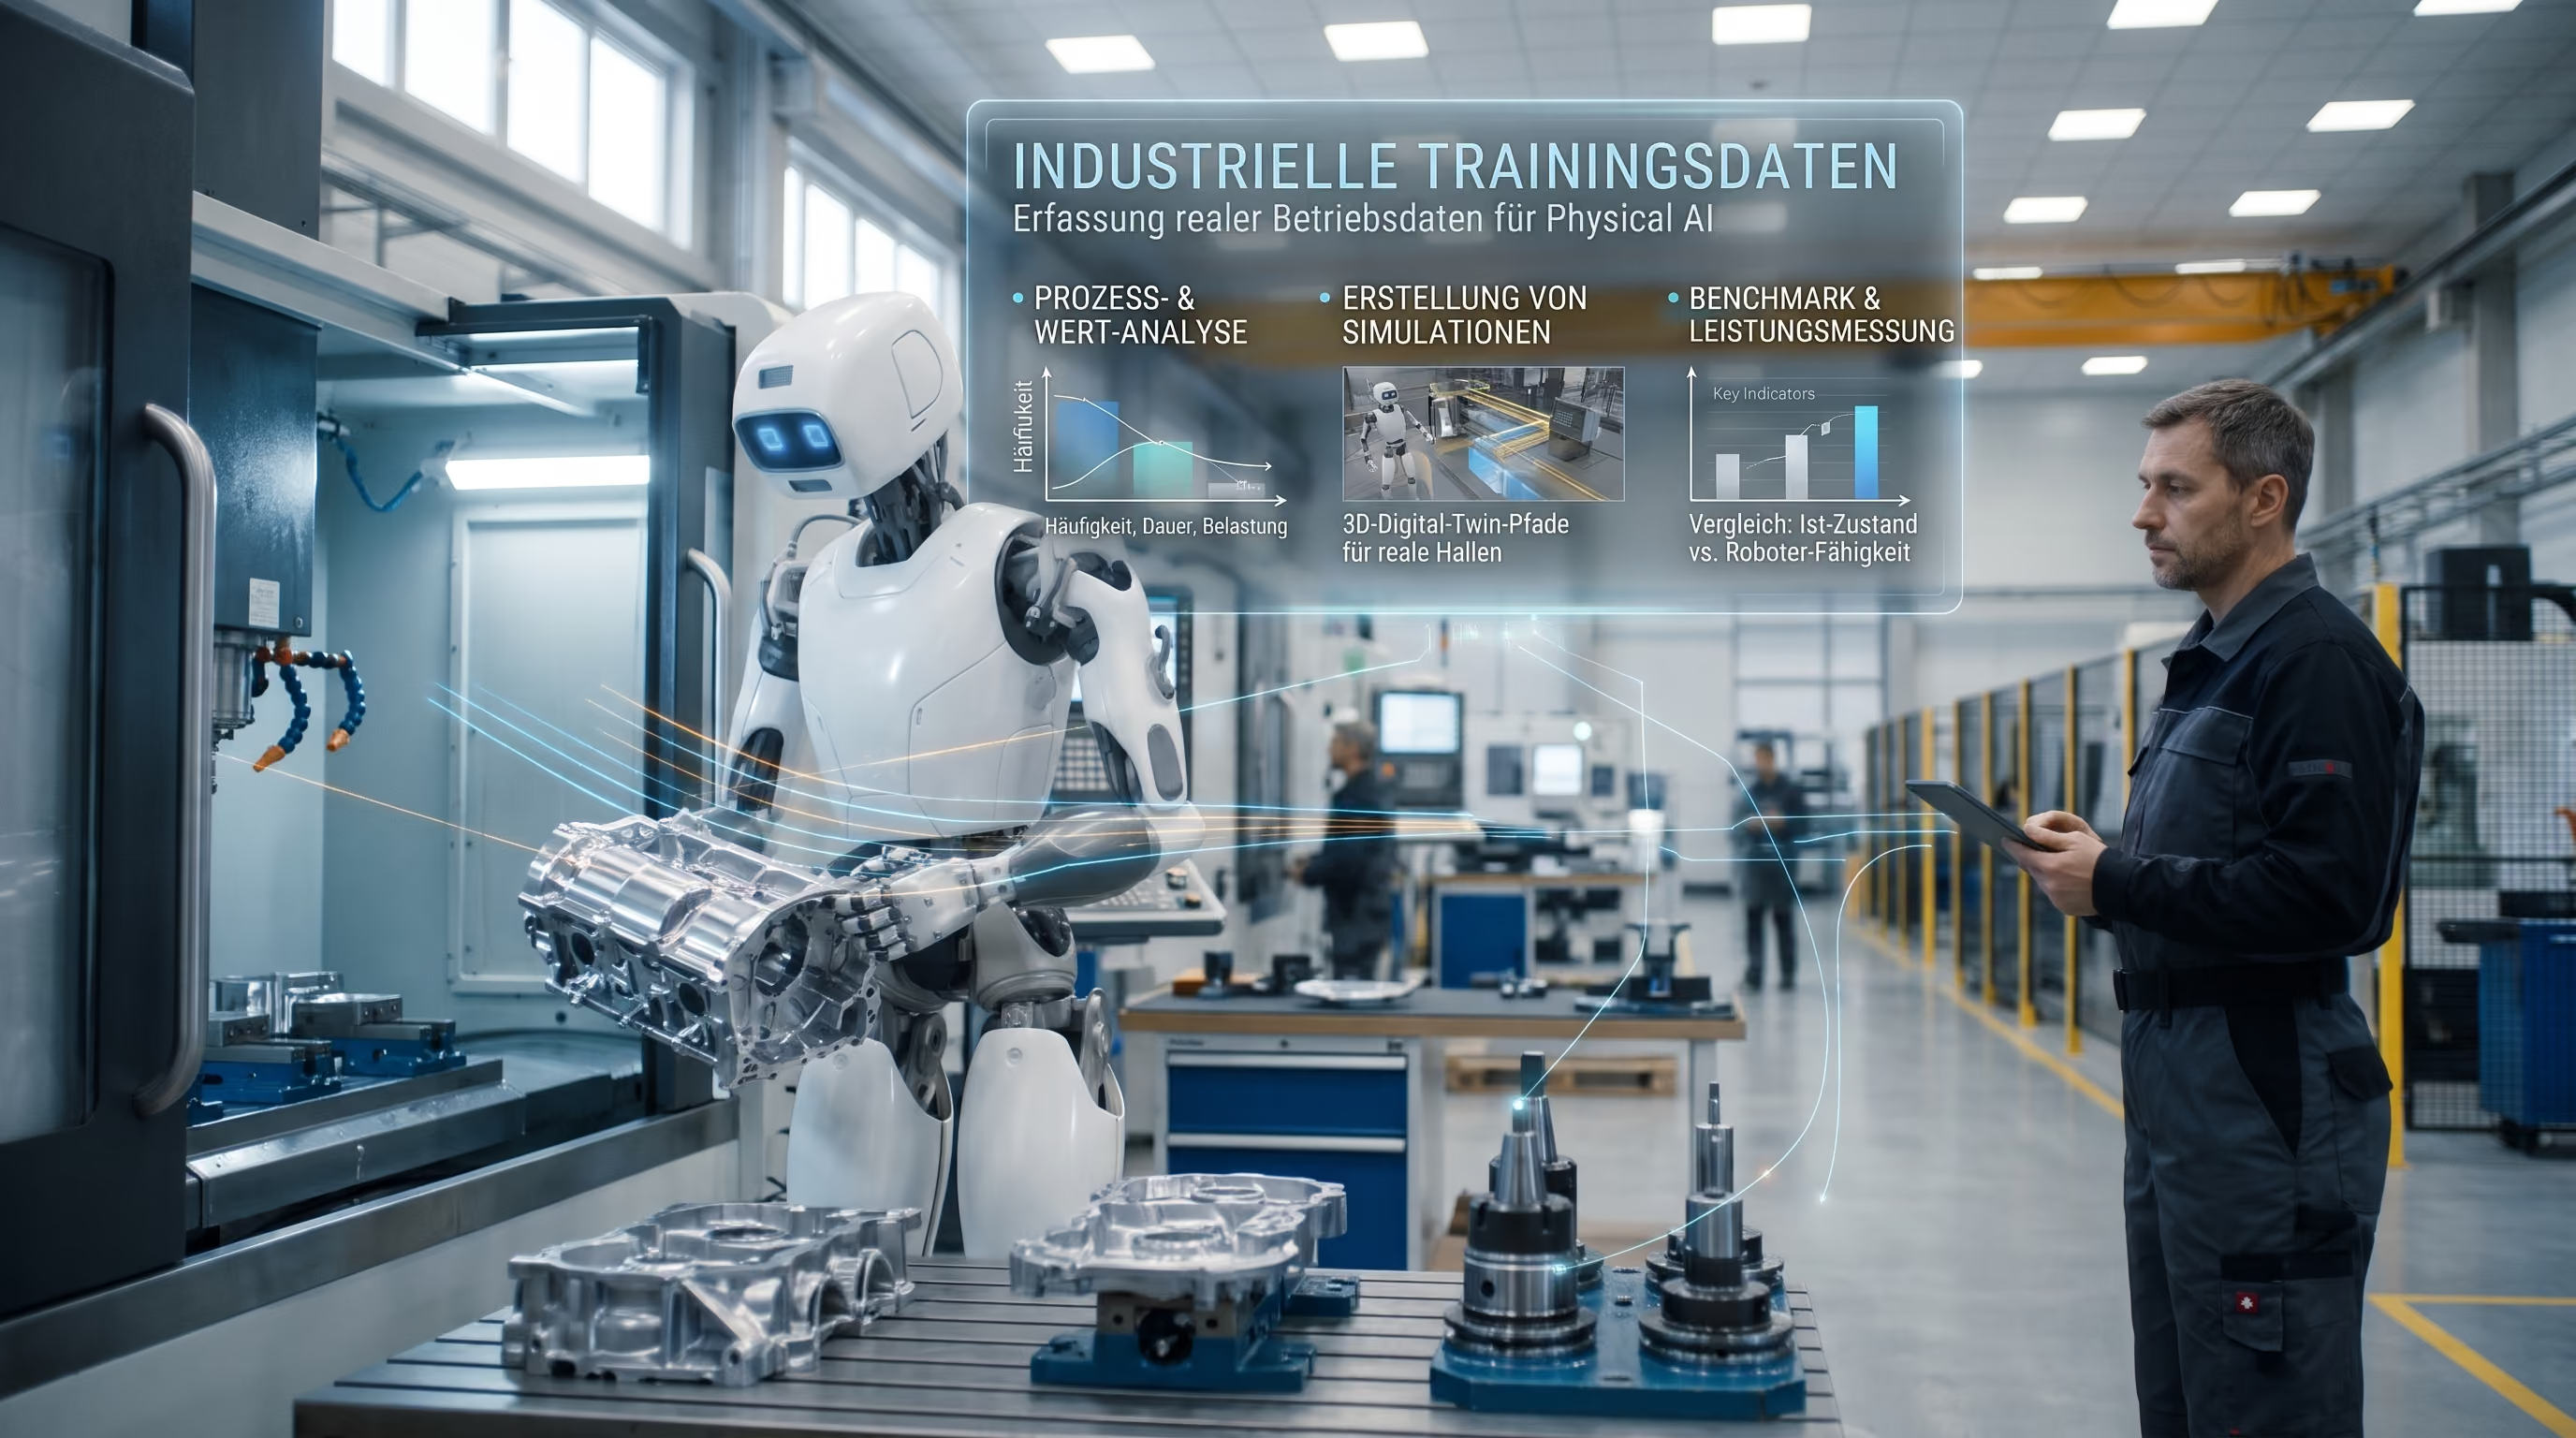
Industrial Training Data bezeichnet Trainings- und Referenzdaten, die aus realer Arbeit in Produktion und Logistik stammen, statt aus Labor oder Simulation. Solche Daten sind für Physical AI auf mehreren Ebenen wertvoll. Zunächst zeigen sie, welche Tätigkeiten sich nach Häufigkeit, Dauer und körperlicher Belastung überhaupt für Roboter lohnen. Außerdem liefern sie die Abläufe, Wege und Variabilität, mit denen sich Simulationsszenarien bauen lassen, die der echten Halle entsprechen. Und schließlich dienen sie als Maßstab: An der heutigen Arbeit muss sich die Leistung eines Roboters später messen lassen.  

DIE SITUATION HEUTE

Was ist die Sim-to-Real-
Lücke?

Die Sim-to-Real-Lücke ist der Unterschied zwischen dem, was ein Roboter in der Simulation gelernt hat, und dem, was in der realen Welt funktioniert. Keine Simulation bildet Reibung, Materialeigenschaften oder Sensorrauschen perfekt ab. Methoden wie Domain Randomization und das Nachtrainieren mit realen Daten verkleinern diese Lücke.